
芯界光核完成数亿元天使轮融资
9月14日,张通社获悉,芯界光核(上海)科技有限公司(以下简称“芯界光核”)近日完成数亿元天使轮融资,本轮融资由元禾璞华、毅达资本领投、微光创投、紫竹科投、清石资管、瀚晖资本等跟投,资金将主要用于产品研发。
芯界光核成立于2026年1月27日,位于上海闵行,公司为上海交大光通讯全国重点实验室科技成果转化项目,联创陆梁军教授长期从事硅光芯片和OCS研发,在光交换方向有十余年积累,联创李雨教授拥有海外产业研发经历,曾在AMF、Marvell从事硅光芯片和CPO的研发。联创应莺、史博均为北京大学计算机系背景,拥有20年以上电芯片研发、硬科技产品开发、商业化和创业企业运营经验。
公司已组建一支顶级复合研发团队,以上交大、港科大、北大、浙大、中科院的博士为主,涵盖芯片设计、先进封装、高速信号完整性等各个方向,拥有Marvell、AMF、华为、百度、小米、IBM、Xilinx、长江存储、中芯国际、华进等行业头部公司核心研发经验。
过去几年,GPU本身的计算能力一直是AI基础设施升级的核心,但当单机、单柜乃至万卡集群的算力密度持续提升后,GPU之间如何高效交换数据,开始成为新的瓶颈。
芯界光核判断,传统电互联正在遭遇功耗、时延和带宽“三重物理瓶颈”。高速电信号传输带来巨大的焦耳热损耗,网络功耗已经成为数据中心能耗的重要组成部分。多级交换和路由又会引入累积时延。与此同时,电背板和铜缆的带宽密度也逐渐逼近物理极限。对于下一代超大规模AI集群而言,算力增长的卡脖子环节可能已经从计算芯片本身转向了芯片之间如何连接。
在这样的背景下,光互联开始从传统数据中心通信的配角,走向下一代AI算力架构的核心基础设施。芯界光核瞄准的正是这一方向,其核心思路是用光信号替代部分传统电信号的数据传输,并进一步将光互联能力直接推向GPU侧,构建 “全光超节点”。
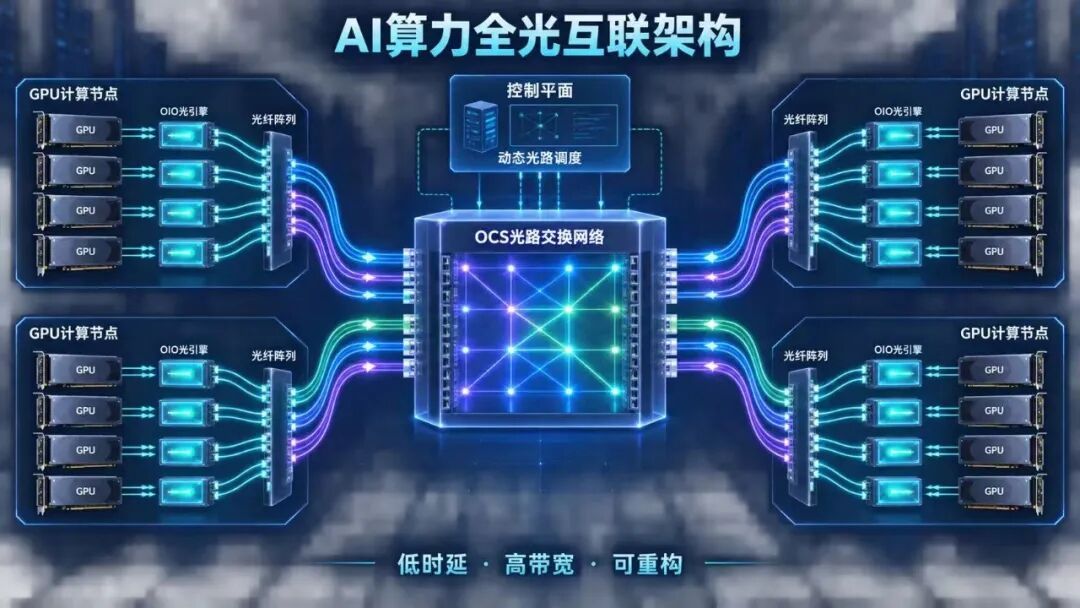
CEO应莺告诉硬氪,当前超节点是由计算单元(xPU)、互联单元(xPO)和交换单元(Scale Up交换机)共同组成的。计算单元规模越大,超节点内的互联单元和交换单元也就越多。公司判断,随着超节点的密度越来越高,未来的架构将由GPU、OIO(光输入输出)和OCS(光交换)共同组成:OIO负责将互联通道由电直接升级为光,OCS则负责在光域完成不同计算节点之间的光路交换,从而减少传统电互联在带宽、功耗和扩展性上的限制。“我们希望最终提供的并不是单一光芯片,而是一套从底层硅光芯片、光引擎,到OCS整机,再到全光超节点的完整光互联产品体系。”
因此,芯界光核的产品主要围绕两条线展开:一条是GPU侧的光引擎/OIO芯粒,另一条是硅光OCS芯片及超节点内全光交换控制系统。其中,GPU侧光引擎产品近期采用团队多年积累的成熟技术方案+先进的3D光电合封工艺,光芯片已经基于12英寸工艺平台流片,3D光电合封正在推进验证,全部生产依托于国内头部供应链联合开发新工艺,自主可控。公司计划在2026年底送样3D高密度光引擎,同时在面积、功耗和带宽等方面持续迭代突破。OCS方面,团队早在2022年就做出了32端口严格无阻塞硅基OCS验证系统,正在进一步向超低插损和更高端口数方向推进,商用版本已准备流片。
当前芯界光核已与多家头部客户达成合作意向,开发基于独特封装工艺的小尺寸高密度强散热的GPU侧的光引擎。应莺介绍,“如果做出来,我们会成为国内第一家能做出此种3D封装结构光引擎的公司且是可量产的方案,在产品侧推动国内光电合封产业向CoWoS-L和COUPE演进。”
评论 (0)