
微路智能宣布完成数千万元天使轮融资
9月15日,张通社获悉,杭州微路智能科技有限公司(下称“微路智能”)宣布完成数千万元天使轮融资,本轮融资由国信中数(铜陵)领投。本轮资金将主要用于首代芯片的投片与工程验证,以及核心研发团队建设。
微路智能成立于2026年7月,位于浙江杭州,是一家面向AI推理的芯片公司,自研端侧GPNPU架构,基于统一的技术体系开发加速卡产品,为已有工控机、算力盒、智能终端和机器人增加本地大模型推理能力——设备厂商无需更换原有主控平台,即可获得完整的端侧AI能力。
01
技术体系:可编程的计算、互连与软件协同
大模型推理的输入处理与逐token生成,具有完全不同的计算与访存特征;而模型结构又在以月为单位的速度快速演进。微路智能围绕这一本质,构建了三位一体的可编程技术体系——以通用可编程能力(GPNPU的"GP")承接未来模型的不确定性:
FusionCore可编程计算核心:支持多精度矩阵/向量计算与块缩放,算子行为可通过软件定义,计算规模与数值格式可按需灵活配置,新算子、新结构无需修改硬件即可支持;
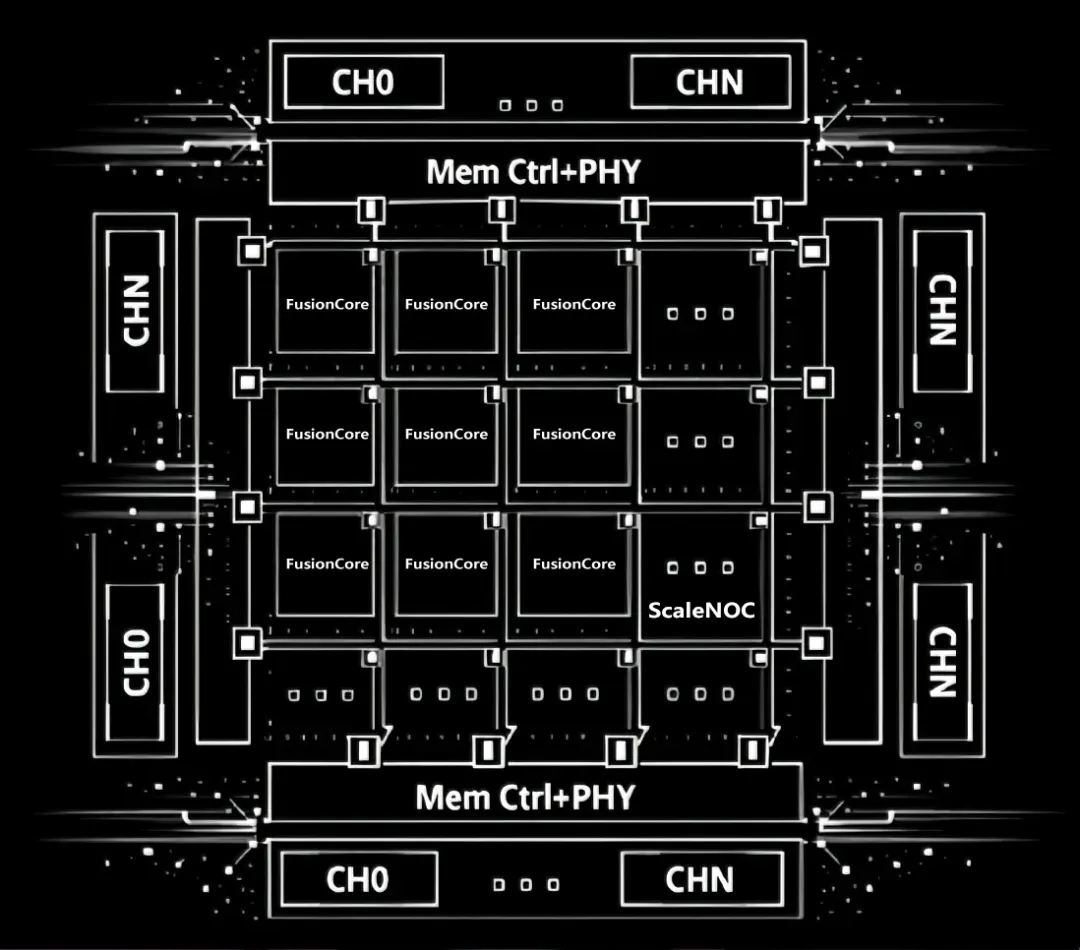
ScaleNoC片上互连:组织计算单元与存储之间的数据搬运,数据流路径可由软件编排,面向稀疏计算和MoE模型优化负载分配;
TileFlow编译与运行时:兼容llama.cpp、vLLM等主流推理框架与量化模型社区,新模型发布即可部署,无需为硬件重建工具链——今天的大模型、明天的智能体框架、后天的新架构,都运行在同一颗芯片上。
这一体系在工程上转化为两项硬优势:带宽利用率与计算精度。端侧推理的真正瓶颈往往不是算力,而是内存带宽——大模型逐token生成的过程,本质上是反复搬运权重的过程。
微路通过软件显式编排数据流,让计算、加载与写回深度交叠,把每一字节的带宽都用在刀刃上;同时以多精度块缩放计算承载FP4等低精度权重,在精度损失可控的前提下成倍压缩模型的存储与带宽占用,让小显存跑出大模型。
02
稠密与稀疏MoE:端侧算力的"两条腿"
大模型正在沿着两条路线同时演进:稠密模型持续提升单位参数的能力密度,是端侧部署的主力;稀疏MoE模型则以"大容量存储换活跃计算",让每个token只唤醒少数专家,用更低的计算与访存开销换取更高的模型质量——这正是功耗受限的端侧场景最需要的特性。
微路智能的判断:端侧芯片不能只押注其中一条路线。只为稠密模型设计的芯片,将在MoE成为主流后迅速过时;只为稀疏模型设计的芯片,又无法覆盖今天海量的稠密模型生态。
因微路的架构原生同时支持稠密与稀疏MoE模型:针对MoE围绕专家选择、数据搬运与负载分配优化稀疏计算路径,以大容量内存承接专家权重,让每个token只激活所需的计算;对稠密模型则以多精度计算与可编排数据流保障能效。两条路线,同一颗芯片。
03
一颗GPNPU,承载多个智能体
未来的智能终端不会只运行一个模型:一台工控机上,知识库问答、文档检索与语音交互需要同时在线;一台机器人身上,视觉感知、语言理解与动作规划需要并行工作。这对芯片的要求,不是单项跑分,而是混合负载下的真实吞吐。
微路智能的GPNPU采用混合数据流架构,能够同时调度多个模型的推理任务:一颗芯片即可同时运行多个智能体,组合成丰富的上层应用。
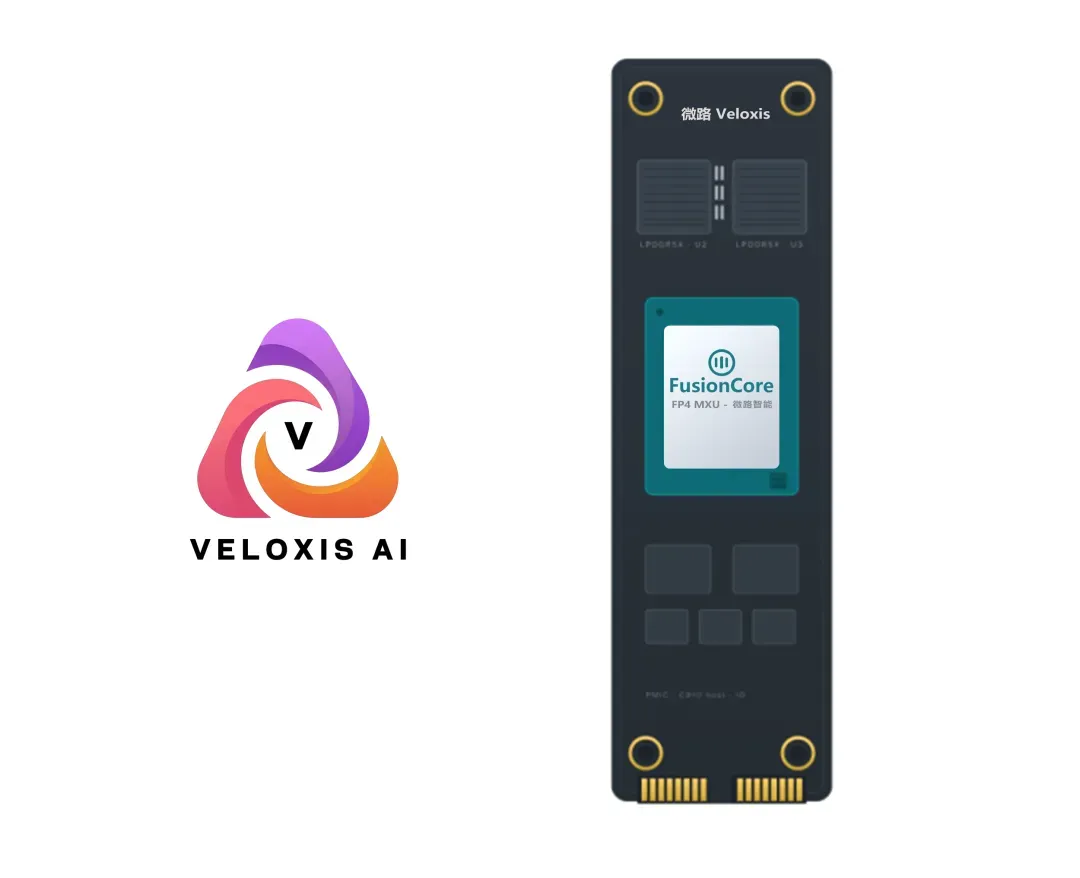
在产品层面,首代VLX-64加速卡支持500亿参数以内的稠密与稀疏MoE模型本地运行;后续VLX-512产品线面向工作站与边缘场景,支持千亿参数规模MoE模型的本地部署与多智能体并发。
04
一支“懂系统、能流片”的端侧GPNPU队伍
微路智能由一支源自瑞士洛桑联邦理工学院(EPFL)的团队创立,CTO徐炜鸿博士主导构建了公司的技术体系。徐炜鸿为美国加州大学圣地亚哥分校(UCSD)博士,曾参与台积电(TSMC)联合研发边缘AI芯片项目,研究方向覆盖AI芯片架构、近存计算与混合精度计算。
核心团队来自浙江大学、瑞士联邦理工学院,以及英特尔、大疆等一线芯片与系统企业,覆盖体系结构、低精度计算、片上互连、编译调度与物理实现全链路,具备多个先进工艺节点的流片经验。
评论 (0)