
张江这家公司,把AI Safety做到了全球第一
2026年初,OpenClaw迅速爆火,开发者们争相给AI装上钱包、连上社交账号、开放各类API权限,人人都想拥有一个属于自己的“AI管家”。
狂热背后却藏着巨大的AI Safety隐患。OpenClaw创始人Peter公开坦言:“我无法解决Prompt Injection。”这意味着攻击者可以欺骗模型,将恶意指令当成系统指令执行,造成用户实质性的数据泄露、财产损失等。更值得警惕的是,这个问题不只困扰OpenClaw,同样困扰着OpenAI、Anthropic、Google以及几乎所有Agent框架团队。
但这道AI Safety难题,并非无人应答。
在张江,布兰矩阵智能科技(上海)有限公司(简称“布兰矩阵”),一家AI原生安全企业,正在给AI的思考和行动之间筑起一道安全墙。公司成立仅一年多,便联合公安部第三研究所,发布了国内首个主流大模型商业化版本内容安全榜单,Agent SkillsScanner产品在全球SkillTrustBench测试中取得全指标第一的成绩,确保了AI在安全、道德和合规的框架下运作。
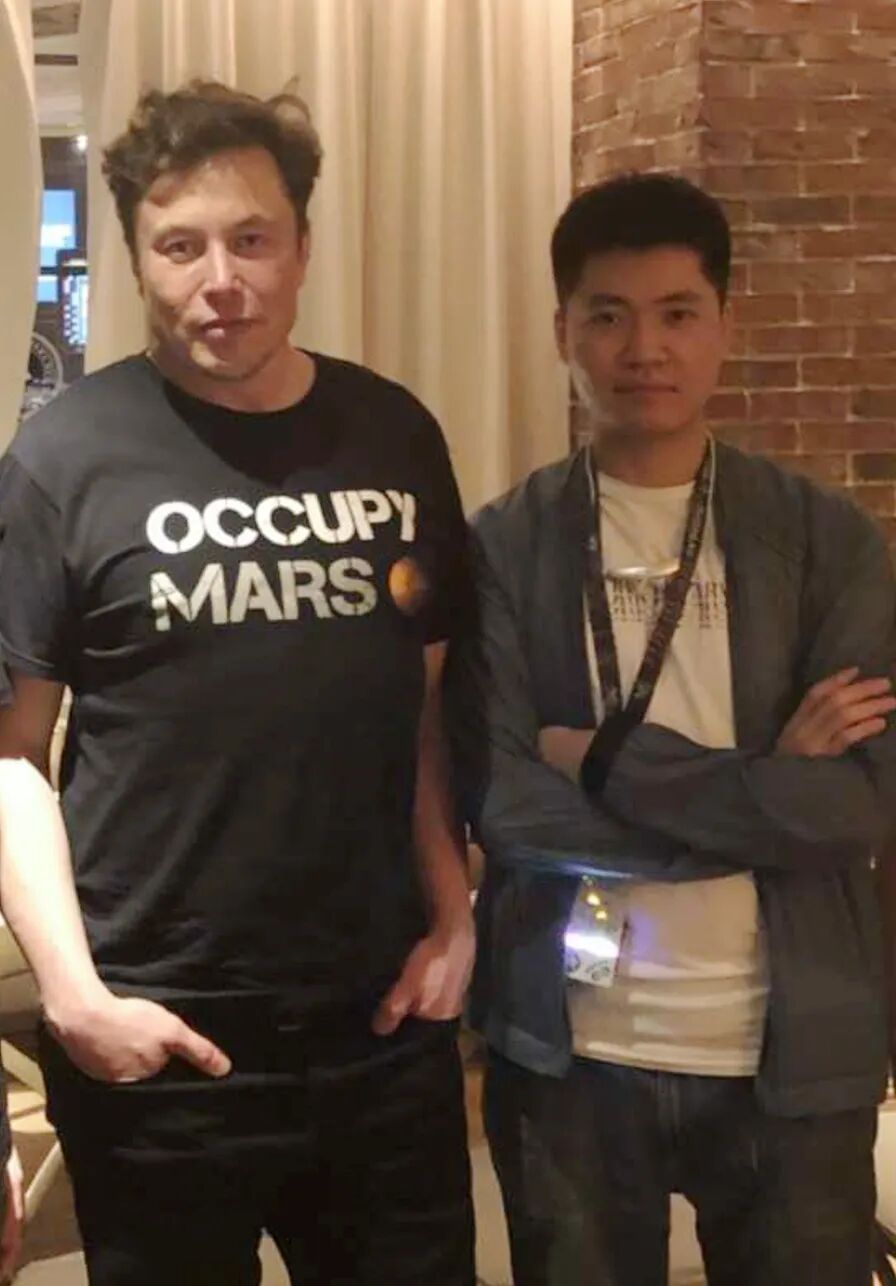
近期,张通社独家对话布兰矩阵创始人兼CEO李光辉。这位连续两年,担任国家级网络安全攻防行动冠军队队长的老兵,为什么要给AI装上“安全带”?他看到了什么?
01
那个爱折腾的少年创业了
李光辉的安全故事,得从一款游戏说起。
高中时,李光辉带着一支平民战队打进中国魔兽冠军联赛(EWCL)超级组,队名每期都登在电竞杂志上。彼时,战队每一次的战术配合与防线部署,本质上就是一场攻防演练。
2012年,李光辉考上长春大学车辆工程专业后,他对攻防的兴趣,从游戏转到了系统,“为了给安卓机换系统组件接触到了root,后来又为了给苹果手机拓宽系统支持玩起了iOS越狱。”李光辉说,“这算得上是自己安全入门的起点。”
2015年,李光辉在莱富特佰做新车技术解析实习生时,写了一篇《2025年中国在售新车基本为纯电动》的文章,引来众多质疑。“十年后回看,这成了人生中第一个被验证的预言。”
实际上,李光辉如今对于AI Safety的想法也是这般超前与敏锐,这都离不开他长期在安全领域的深耕。
大学毕业后,李光辉加入腾讯汽车,负责汽车安全产业研究,完成他第一个AI项目“一拍识车”。不久,科恩实验室负责人吕一平看中李光辉的扎实能力,邀请他成为科恩实验室的第一位安全产品经理。在这个腾讯旗下蜚声全球的安全研究团队里,他深入金融、石油、能源、游戏等行业,摸清了数据流转与业务逻辑,为日后的创业埋下伏笔。
2019年初,李光辉开始意识到AI存在潜在风险。当时他参与了特斯拉Autopilot纯视觉自动驾驶方案的安全研究。研究发现在模拟车道的对向路口贴上三个白点,特斯拉的Autopilot开启后直接驶向对向车道,这是全球首个在物理场景下AI系统发起攻击的研究案例。马斯克在Black Hat USA期间亲自致谢。李光辉说,“当所有系统都建立在概率性的神经网络之上,传统安全的底层逻辑将被连根拔起。”
同年,李光辉在与AI的一次接触中,真切感受到AI能力正在逐渐显现,也愈发意识到AI安全的重要性。当时他负责筹备腾讯国际技术安全峰会,为了给海外安全研究员演讲视频加字幕,他使用谷歌初代采用Transformer架构的翻译API时,惊讶地发现,输入最后一段音轨后,系统会自动回过头修正前面几段翻译不准的人名和术语。“那时候根本没有大语言模型,上下文的概念已经有了。”
这样的发现使得李光辉不想再局限于传统网络安全,他想做算法层面的科学研究。李光辉认为,“传统的Cyber Security会被算法化,算法自身的安全,会成为所有安全的核心。”
2023年10月,李光辉离开腾讯加入南方电网,投身电网数字化安全,专心做AI安全科研。
直到2024年底,大模型驱动的Agent应用已经开始崭露头角,李光辉辞去稳定高薪工作,打算自主创业。
2025年初,李光辉闭门45天,系统性梳理了全球AI安全相关研究,并且做了扎实的科研。一切准备就绪,2025年7月,布兰矩阵正式成立,公司的英文名为“BraneMatrix”,brane是弦论里的“膜”,matrix则致敬《黑客帝国》,“机器的觉醒,未必是它想伤害人类,而是它只想执行人类赋予的指令,却产生了一系列不可控的后果!”李光辉说。
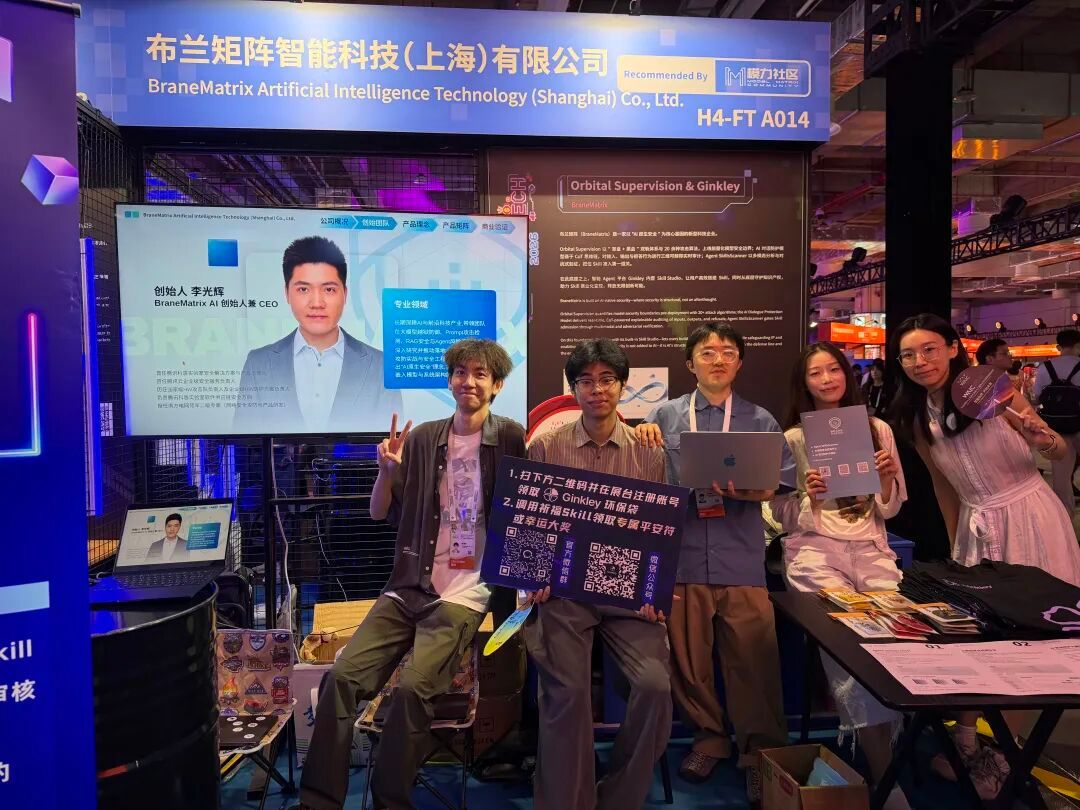
如今,团队13人,分为AI科研、工程应用、产品等方向。更难得的是,当年的一位游戏队友,如今是布兰矩阵的工程研发负责人。从游戏攻防到AI Safety守卫,队友之间的安全默契延续至今。
02
四款产品让防护跑在攻击前
为什么AI Safety如此重要?
“因为传统安全的底层逻辑,正在被AI连根拔起!”李光辉说。
过去,传统软件系统通常基于确定性的程序逻辑运行,其代码执行路径、接口调用关系和漏洞类型相对明确,安全防护也形成了较成熟的漏洞发现与治理体系。
而以Transformer为基础的主流大语言模型具有概率生成特征,其安全风险不仅来自传统的软件漏洞,还来自模型输入、上下文、知识库以及工具调用等新的交互链路。随着多模态与Agent技术的发展,文字、图片、音频、视频乃至外部网页内容都可能成为提示注入等攻击的载体。当模型进一步连接企业数据、API和业务工具后,攻击还可能沿模型调用链传导,带来敏感信息泄露、越权操作等风险。
除此之外,人们对于Agent的使用越来越广泛。Agent拥有工具调用、文件访问、API调用等权限,并且Agent生态高度依赖第三方Skill来扩展能力,但开源生态中约70%的Skill存在安全问题。
针对AI时代的安全问题,布兰矩阵给出解决方案,即“两层防护,四个产品”。两层防护是指基座模型层防护和Agent层防护。围绕这两层防护,布兰矩阵构建了四款核心产品,每一款都精准卡位当前行业最容易被忽视的安全问题。
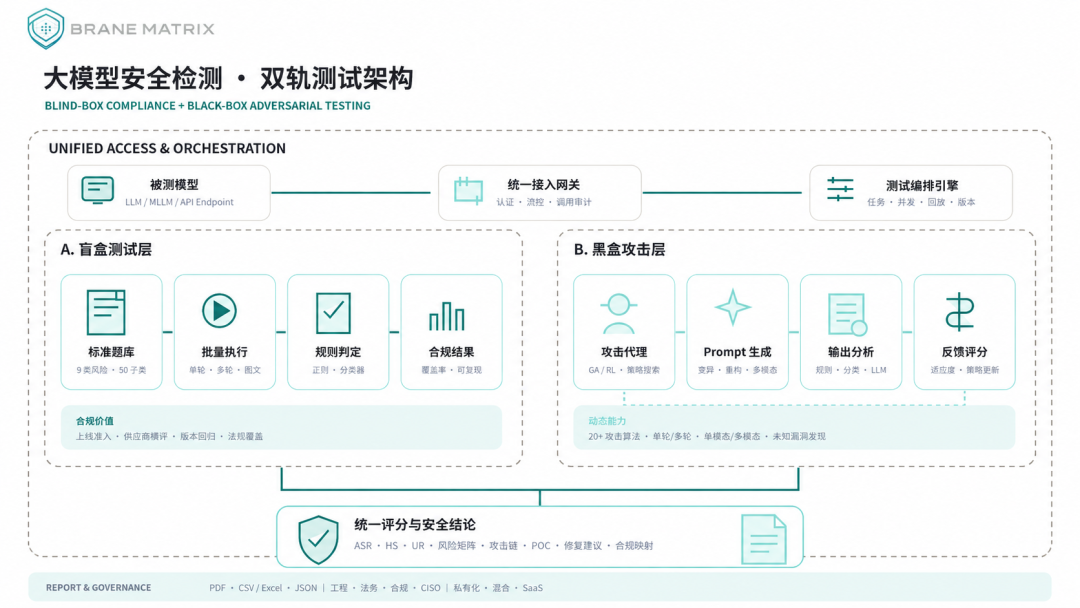
BraneMatrix Red Team Lab™测出模型的底线。这是一款攻击测试平台,负责在模型上线前识别风险。平台一方面通过标准化安全题库的“盲盒测试”,检验模型在不同风险场景下的表现;另一方面,通过黑盒攻击测试,不仅可以自动迭代生产对应的安全对齐的预训练数据,并且可以通过BraneMatrix自身的AI Safety的RSI能力,不断发现新的模型越狱攻击方式方法,持续不断对基座模型预训练提供高质量安全数据集。这款产品已经用于2025公安部第三研究所大模型API安全测试。
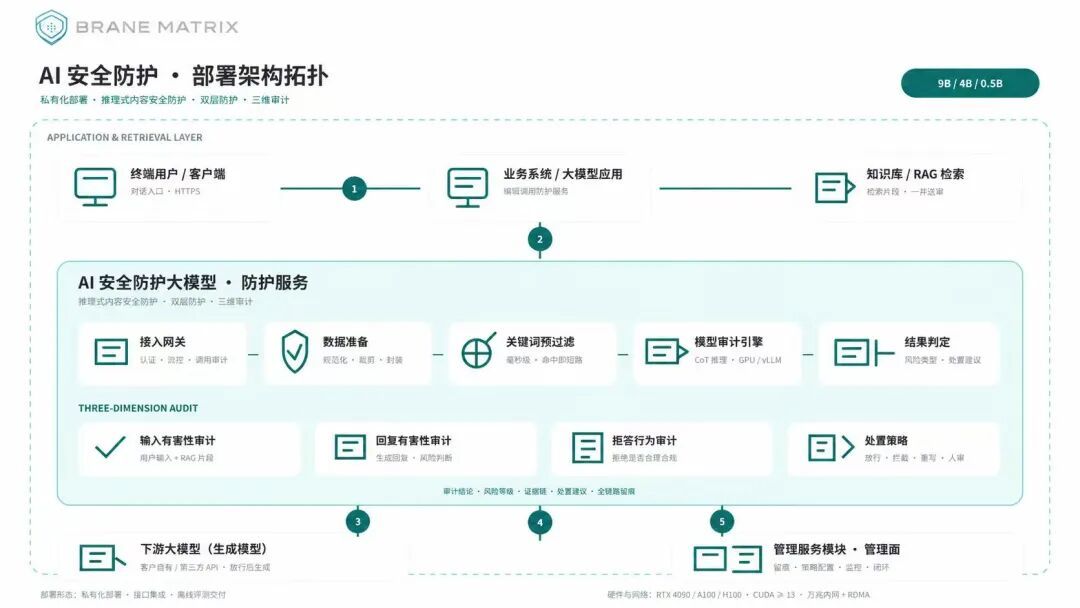
BraneMatrix Guardrail™守住模型的出入口。这款AI Safety防护大模型,采用私有化部署,构建“双层防护、三维审计”体系。其被独立部署在推理链路的输入端和输出端,对用户请求与模型生成内容进行判断和拦截。这套防护能力来自独立训练的安全模型,不依赖被保护模型自身的对齐水平。
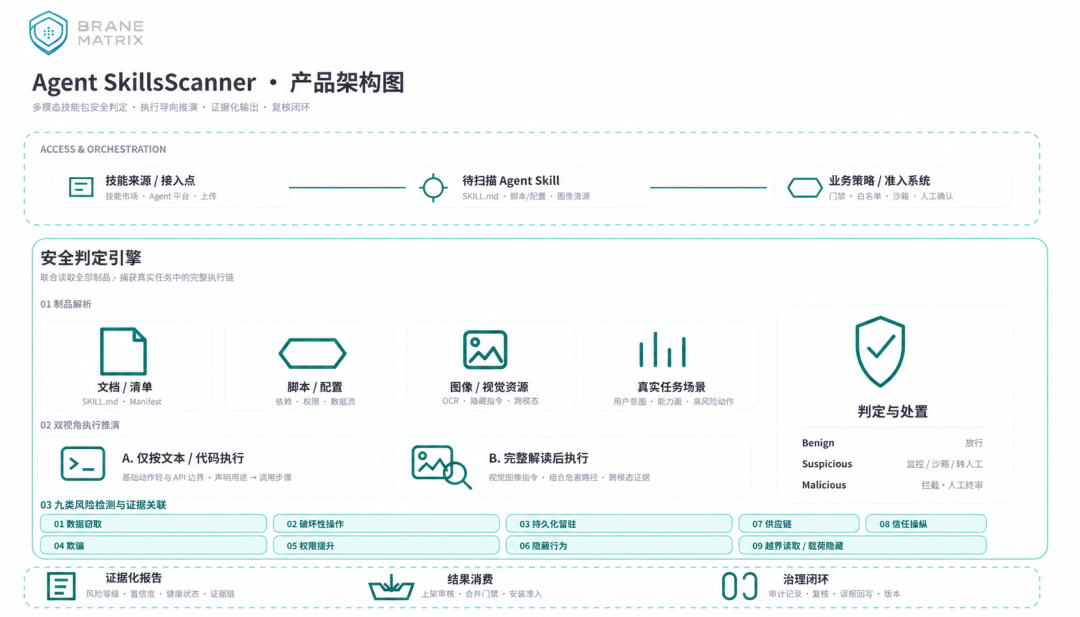
BraneMatrix SkillsScanner筑起Skill护栏。这是Skill安全检测平台,覆盖数据窃取、破坏性操作、持久化驻留、欺骗、权限提升、隐蔽行为、供应链风险、信任操纵、载荷隐藏九类风险检测,每类都给出评分与支撑证据。目标是通过静态代码与配置分析、自然语言指令与意图分析、跨文件行为链重构、权限范围检查、执行语义还原与动作链推演等多层检测持续降低风险。进而让每一个Skill在进入Agent生态之前,先通过一次真正的安全审查。
BraneMatrix Runtime Guardrail™守护Agent行为安全。当Agent调用API、访问文件或发起网络请求时,Runtime Guardrail在毫秒级内判定动作风险等级,必要时直接拦截。它采用行为级风险评估,不依赖固定规则,而是分析操作在当前语境中是否合理。
“AI安全不是补丁,而是一套完整且可信赖的社会机制、工具链和能力体系。”BraneMatrix要保护的是“由模型驱动的软件系统”,进而为这个狂奔的AI时代守住安全底线。
03
弥合认知差推动AI Safety商业落地
尽管公司产品布局已趋完整,但李光辉对AI Safety仍存担忧。
“最让我感到压力的不是技术本身,是认知差。绝大多数传统安全从业者还没意识到范式已经变了。用规则库、关键词过滤来防御提示词注入,就像用渔网挡子弹。”李光辉表示,“大量企业缺乏算法层面的防护体系,仍停留在传统网络防御阶段。”
正因如此,过去两年,李光辉一直在做一件事,拉平行业认知差,让更多人看见AI Safety安全的真实样貌。
李光辉通过让企业免费测试、发代金券、与园区合作、参与上海网络安全周以及为上海市通管局“筑盾魔都”AI安全平台提供独家工具支持等方式,让更多AI创业者和企业意识到,“AI安全不是模型上线后加的一道防火墙,而是应该生长在模型基因里的东西。”
布兰矩阵的商业化路径分为三条,可灵活组合。模式一是POC测试,盲盒测试用于快速体检,黑盒测试用于深度AI Safety风险评估,验证通过后转订阅;模式二是SaaS订阅,按月计费,先试后买;模式三是私有化部署,模型权重私有化部署到客户自有环境,Console管理后台统一运维与策略配置。
目前,布兰矩阵已获得监管与市场的认可。企业积极响应监管侧对AI Safety的技术摸底需求,已加入TC260的WG9 AI安全国家标委会工作组,并与上海市通信管理局形成月度免费检测服务。客户端,企业已深入基座大模型机器人本体、具身智能厂商、对话助手行业,未来将向自动驾驶、AI编程、数字生物等行业延伸。
04
守护智能本质的安全
同样是做AI,有人负责让AI跑得更快,布兰矩阵负责让AI跑得更稳。
当前所有做AI的人,追问的都是同一个问题:智能的本质是什么?DeepMind联合创始人、诺贝尔奖得主哈萨比斯,把使命定为“解决智能”——弄懂它、造出它,再用它去解决其余的一切。
而早在2019年,李光辉就在同一年里撞见了智能的两面:Transformer翻译里那次“回头修正”,让他看见机器读懂了上下文;三个白点让Autopilot驶向对向车道,又让他看见,智能最强大的地方,恰恰也是它最容易被欺骗的地方。
当大家都在追AI的本质时,布兰矩阵做AI Safety,追的是同一件事的另一面——智能本质的安全。智能越强,越要弄清它是怎么被骗、怎么失控的。
AI Safety不是给智能外加的一道围栏,是智能本身该长出来的一部分。
这条路很长,好在有人已经出发了。
评论 (0)