微路智能完成千万级天使+轮融资
10月21日,张通社获悉,杭州微路智能科技有限公司(简称:微路智能)在宣布完成数千万元天使轮融资后,再次获得千万级天使+轮融资,本轮由杭州中赢资本(杭州中赢创投)领投。微路智能2026年7月成立于杭州钱塘区,9月完成数千万元天使轮(国信中数铜陵科创基金领投),10月完成天使+轮,成立三个月连融两轮。
三个字母的战争:GPU、NPU、GPNPU
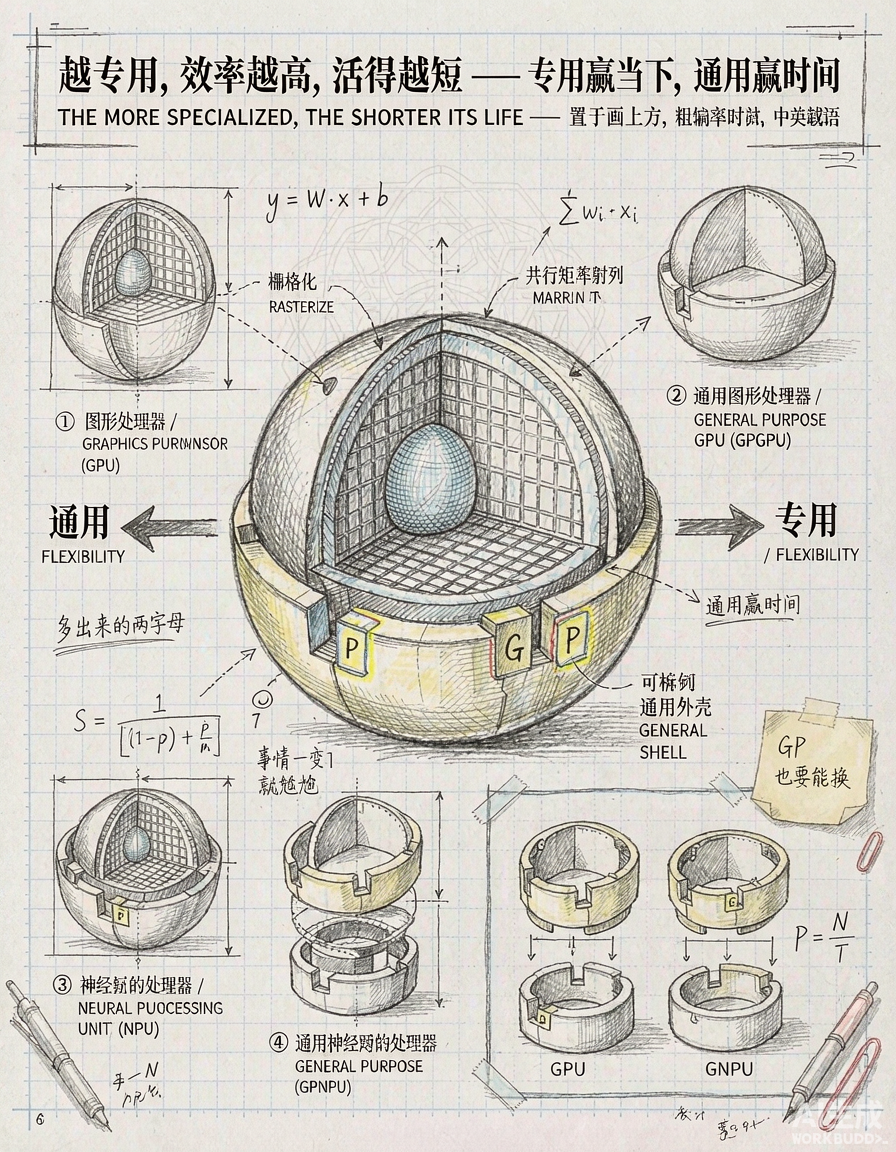
微路智能成立于2026年7月,位于浙江省杭州市,定位端侧AI芯片,技术路线为GPNPU(General Purpose NPU,通用神经网络处理器)。GPU擅长大规模并行计算,NPU专注矩阵乘法与卷积运算、同样功耗下更快更省但专用性强;芯片从定义到量产通常需18至24个月,而模型结构以月为单位迭代(从稠密模型到MoE、从单模型到多智能体并发),GPNPU意在通过软件定义让专用流水线兼顾通用,解决“立项时对标的模型流片回来已过时两代”的行业痛点。
端侧有多难:三个不能商量的约束
端侧芯片面临功耗、成本与存量设备兼容三重硬约束:工控机7×24小时运行、整机功耗预算常仅几十瓦;BOM成本决定端侧芯片定价逻辑;国内几千万台工控机、几十万台存量机器人不可能为大模型推倒重来,端侧产品形态往往是插在主控旁的加速卡,通过标准接口把本地推理能力“挂”上去。公司方案即在几十瓦功耗、可接受成本下运行几百亿参数模型,且不要求客户改架构。
微路智能:一个“不换主板”的方案
微路智能技术体系由三块构成:FusionCore可编程计算核心,支持多精度矩阵/向量计算与块缩放,算子行为由软件定义,应对模型结构变化;ScaleNoC片上互连,数据流路径可由软件编排,针对稀疏计算与MoE负载分配优化;TileFlow编译与运行时,兼容llama.cpp、vLLM等主流推理框架和量化模型社区,新模型发布即可部署。产品层面,首代VLX-64加速卡面向500亿参数以内的稠密与稀疏MoE模型本地运行,后续VLX-512产品线面向工作站与边缘场景,支持千亿参数规模MoE本地部署与多智能体并发。
团队源自瑞士洛桑联邦理工学院(EPFL),CTO徐炜鸿博士为UCSD博士,曾参与台积电联合研发的边缘AI芯片项目,研究方向覆盖AI芯片架构、近存计算与混合精度计算;核心成员来自浙江大学、瑞士联邦理工以及英特尔、大疆等企业,覆盖体系结构、低精度计算、片上互连、编译调度与物理实现全链路。
上一轮领投方国信中数表示,端侧推理算力是“人工智能+”落地绕不开的底座,团队具备EPFL/UCSD学术背景与多次流片工程履历,GPNPU路线是制程受限条件下中国团队有可能做出架构级差异化的方向;AI推理下半场在端侧,从云到端是AI进入物理世界的最后一公里,公司能否走远取决于第一批工控机和机器人能否在真实车间连续稳定运行。
冷静一下:这条路上还有几道坎
赛道同时存在三道坎:一是流片是生死线,首次流片能否点亮、性能达仿真值七八成、功耗是否超预算是真正分水岭;二是端侧需求碎片化,工控、机器人、AI PC、安防、车载场景的功耗预算、接口、认证要求各异;三是开源栈llama.cpp、vLLM成熟降低了生态门槛,但“兼容”也意味着难形成锁定,最终壁垒落在同硬件下多跑出性能的工程细节上。
评论 (0)